

2026年10月23日,学院袁慎立教授联合北京生命科技研究院和山东大学生殖团队,在国际期刊Nucleic Acids Research发表题为“scTHREAD: a cell-resolved long-read transcriptome database with linked isoform, poly(A), junction, and allelic evidence”的研究论文。
基因水平表达分析难以揭示转录本异构体在不同细胞中的调控差异。现有单细胞数据库主要基于短读长测序,缺乏完整异构体信息。尽管长读长测序能够解析转录本全长结构,相关数据仍分散于公共数据库,缺乏统一标准、可追溯证据及开放整合平台。
为此,研究团队同步推出单细胞长读长转录组数据库平台scTHREAD。该平台整合了GEO、ENA和GSA的34个数据集、453个测序run及923,389个细胞,覆盖ONT与PacBio两大平台、16种组织和6大生物学系统,并建立统一标准化流程。数据库收录1,247万条转录本观测记录,其中30%为已注释转录本,70%为新结构。
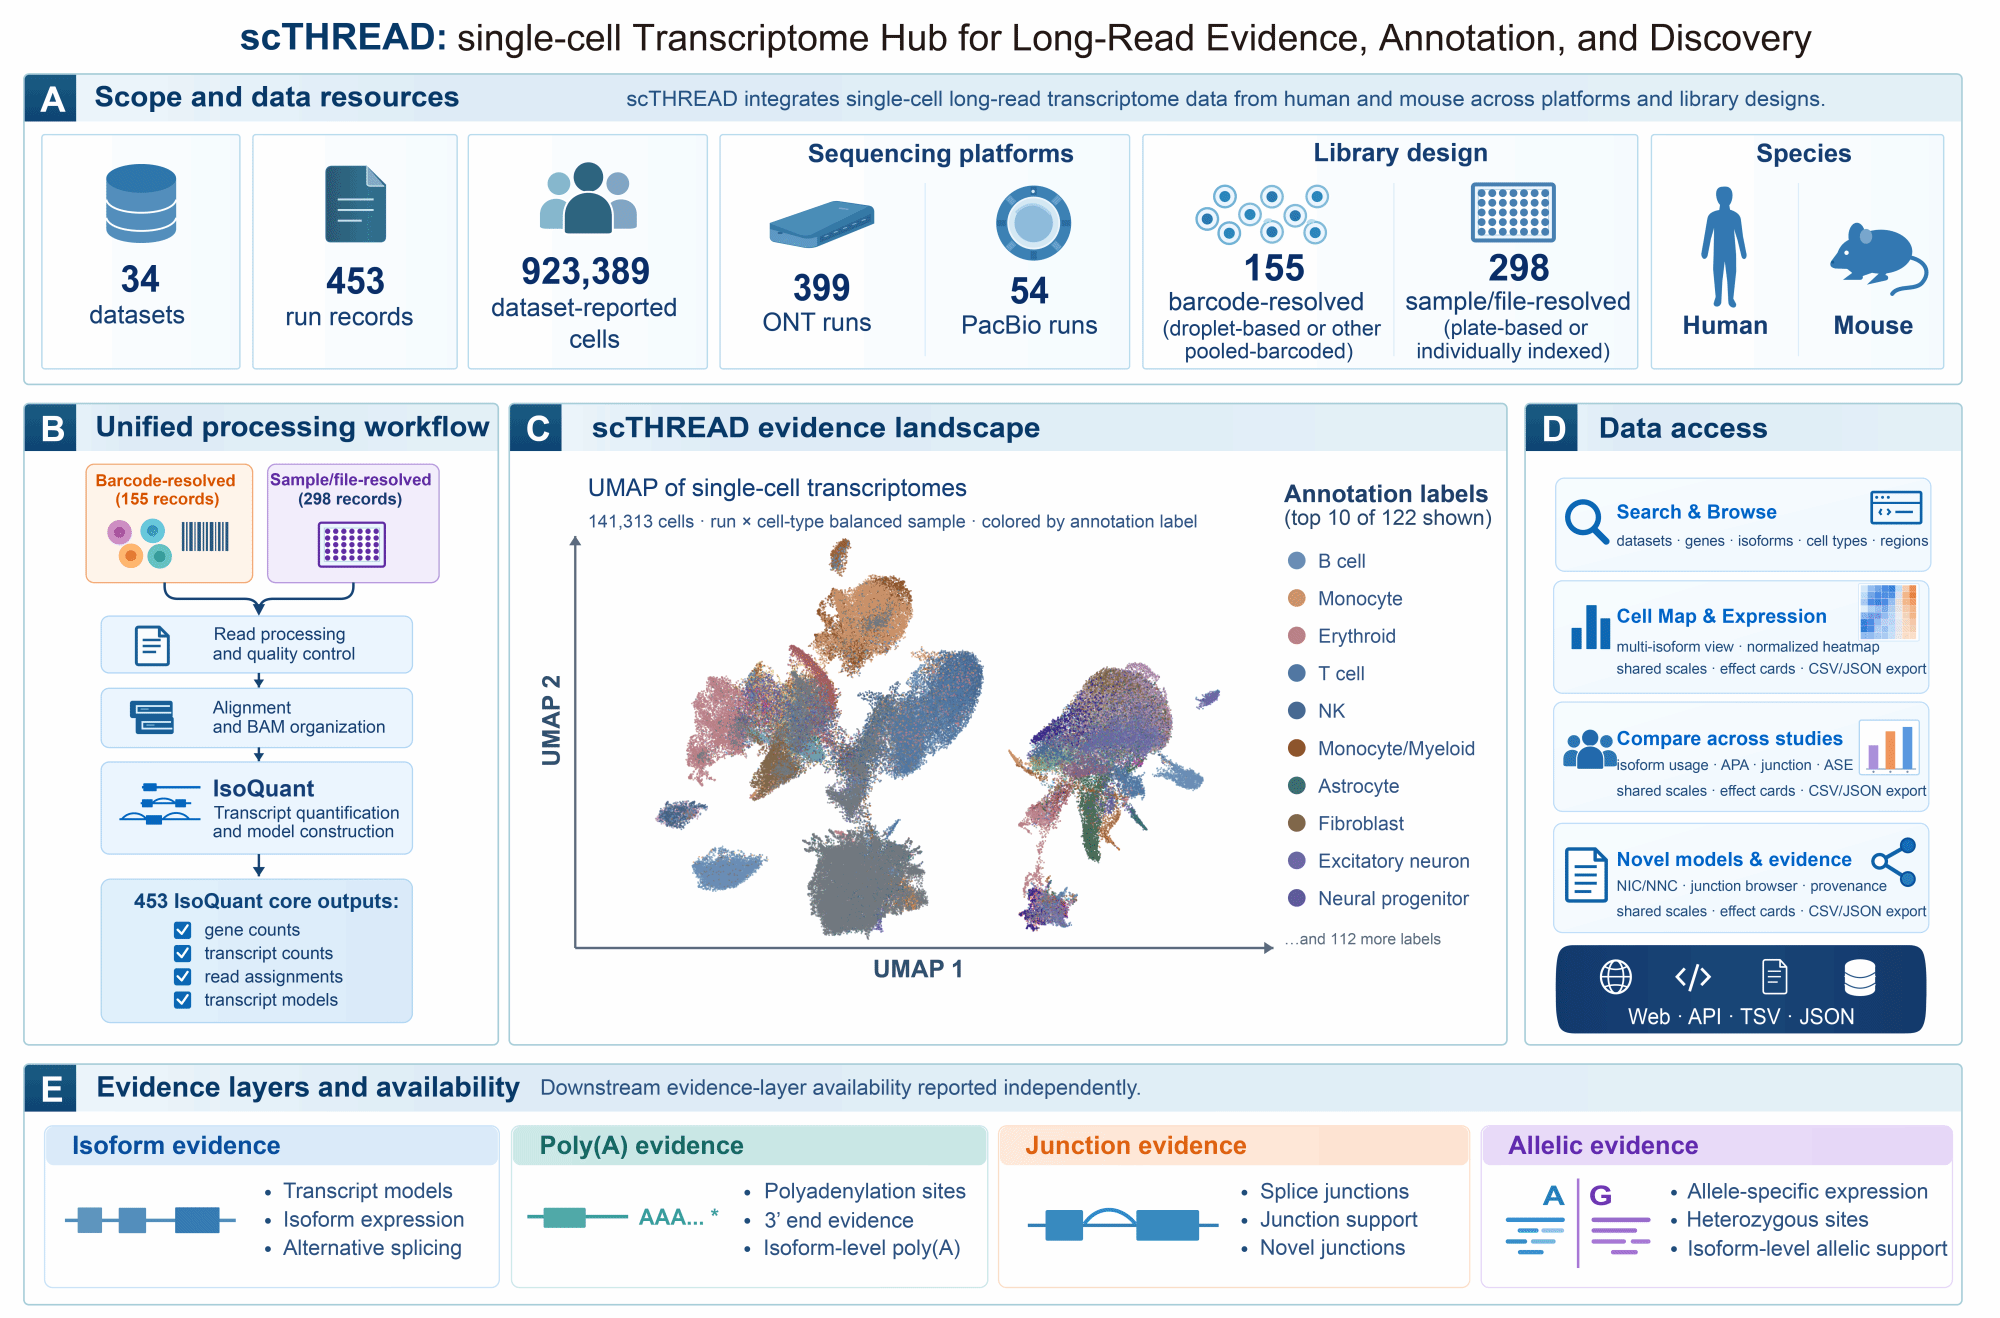
scTHREAD数据库总览:数据规模、标准化处理流程与网页检索界面。
scTHREAD的核心亮点如下:
一、单细胞分辨的转录本多维证据关联。每个基因页同时提供转录本异构体使用比例、poly(A)位点使用、剪接junction支持与等位基因表达四层证据,全部与来源研究、测序run、细胞类型乃至单个细胞逐一挂钩。在数据库覆盖的骨髓数据中,可评估异构体使用的基因携带7种(中位数)异构体,可评估3'端结构的基因携带15个(中位数)poly(A)位点。
二、完整溯源,可比较、可复核。 每条记录都保留”研究→run→样本→细胞→证据”的完整来源链;公开的处理清单(processing manifest)逐run登记处理路由、计数单位、各证据层可用性与校验和;“未检测到”与”无数据”被严格区分,跨研究比较只在明确定义的统计单位上进行,避免跨平台数据被不当混合。
三、转录本结构本身就是细胞身份的标记。对17亿条分类剪接读段的分析显示,44.6%携带参考注释中没有的结构;且”新结构比例”随细胞类型系统变化——从红系细胞的8%到恶性浆细胞的80%,并在独立队列间高度一致(Spearman ρ=0.83)。这意味着仅靠基因表达无法完全分辨的细胞状态,可以在转录本结构维度上被进一步区分。
四、既能复现已知,也能发现新规律。 在经典免疫标记PTPRC(CD45)位点,数据库仅凭长读长数据即重现了著名的CD45亚型转换:B细胞91%的信息读段剪接进入可变外显子A(跳过全部三个可变外显子的CD45RO型读段仅0.4%),单核细胞则主要剪接进入外显子B(52%)。更进一步,基于数据库的检索鉴定出CCND3、CUTA、PSMB8三个基因的单核细胞–T细胞剪接junction使用差异,并在13供体发现队列、4供体留出队列与20供体独立短读长队列的每一供体中一致复现,横跨两种测序技术。
综上,scTHREAD填补了单细胞长读长转录组多研究整合的空白,将单细胞数据库从传统的“基因表达图谱”拓展为“细胞分辨的转录本结构证据库”。通过统一处理、完整溯源、开放共享与持续更新,实现分散数据的统一检索、交叉验证与再分析,为RNA加工调控、转录本异构体功能及等位基因表达研究提供了重要的数据基础设施。
未来,团队将持续扩充物种与组织覆盖,并探索空间长读长测序与direct RNA测序(将RNA修饰与转录本结构、poly(A)位点、等位基因和细胞类型关联)等方向的整合。
袁慎立、山东大学黄涛和北京生命科技研究院陈勇为共同通讯作者,付志灿博士与闫业联博士为本文共同第一作者。我院为本文第一署名单位。
该研究得到国家重点研发计划、国家自然科学基金等项目资助。
原文链接:https://academic.oup.com/nar/advance-article/doi/10.1093/nar/gkag1038/8986426